我有一台旧电脑,上面有一块1650,虽然尝试过LLM,但是对于生产力(编程)来说,部署不了太大的模型,所以另辟蹊径,决定试试文生图,于是有了这次探索……
(封面图:SANA-Sprint 在 GTX 1650 上生成的 1024×1024 图像)
一、先摸清家底:这块 1650 还能干什么
旧电脑配置如下:
| 项目 | 配置 | 评价 |
|---|---|---|
| GPU | NVIDIA GTX 1650,4GB 显存 | Turing 架构(SM 7.5),无 bf16 单元、无 Tensor Core 优惠 |
| CPU | 6 核 x86_64 | 中规中矩 |
| 内存 | 16GB | 关键——它是"第二显存" |
| 磁盘 | 457GB,剩余 333GB | 放模型绰绰有余 |
4GB 显存是什么概念?现在主流开源文生图模型的显存需求大致是:
| 模型 | 参数规模 | 原生分辨率 | FP16 显存需求 | 4GB 卡可行性 |
|---|---|---|---|---|
| SD 1.5 | ~1B | 512px | ~2.5GB | ✅ 舒适 |
| SDXL | ~2.6B | 1024px | ~7GB | ⚠️ 勉强(需量化+offload) |
| SD 3.5 Large | 8B | 1024px | ~16GB | ❌ |
| Flux.1 Dev | 12B | 2048px | ~24GB | ❌(量化版勉强) |
| Qwen-Image | 20B | 1328px | ~40GB | ❌ 别想了 |
| Sana 1.6B | 1.6B | 1024px | ~6GB | ⚠️ 有戏(分时复用) |
| SANA-Sprint 1.6B | 1.6B | 1024px | ~6GB | ⚠️ 同上,但只要 2 步 |
结论很清晰:第一梯队(Flux、Qwen-Image)的原生推理无缘,但 SD1.5 舒适、Sana 系列够得着。我的目标是——不将就 SD1.5 的画质。
二、diffusers 还是 ComfyUI?想清楚"给谁用"
动手前先做选型。ComfyUI 名气大,但我的需求很明确:程序调用,不关心界面微调。
| 维度 | diffusers | ComfyUI |
|---|---|---|
| 定位 | Python 库(HuggingFace) | 节点式图形应用 |
| 调用方式 | 直接写 Python | HTTP API + 拼 JSON 节点图 |
| 界面 | 无 | 完整 WebUI |
| 显存优化 | cpu_offload 一行代码 | --lowvram 启动参数 |
| 适合场景 | 嵌入应用、批量生成、API 服务 | 交互式创作、工作流实验 |
给 AI/程序调用的话,让程序去构造一长串节点图 JSON 是自找麻烦。diffusers 几行代码就是一个生成函数,果断选它。
环境:Python 3.10 + 独立 venv,装 torch(CUDA 版)、diffusers、transformers、accelerate。
三、第一课:国内下载模型,先测速再动手
torch 的 CUDA 包有 2.5GB+,huggingface 直连基本龟速。我先把国内常见镜像源全部测了一遍(同一文件读 200KB 计速):
| 源 | 延迟 | 带宽 |
|---|---|---|
| 阿里云 pypi | 0.39s | 502 KB/s ✅ |
| 中科大 | 0.52s | 379 KB/s |
| 豆瓣 | 0.73s | 266 KB/s |
| 清华 | 1.10s | 178 KB/s |
| pypi 官方 | 0.96s | 204 KB/s |
| pytorch 官方 | 0.93s | 60 KB/s |
模型本体走 ModelScope(魔搭)——对比相当残酷:HuggingFace 镜像同样时间下了不到 5MB,ModelScope 几分钟 293MB,最终 9.3GB 模型 37 分钟下完。
教训 1:动手下载前,先花一分钟测速选源,能省几小时。
还有个坑:ModelScope 上的仓库经常把 FP32/FP16/ckpt/分片格式全打包(Sana 首轮下载冲到 25GB!)。用 snapshot_download 的 allow_patterns 参数只拿需要的文件,或者下完手动清理,能省一半磁盘和一半时间。
四、SD1.5 基线:一张黑图引发的"侦探案"
SD1.5 下载完,25 步出图 143 秒、显存峰值 2.48GB——数字都很美好,直到我打开生成的图:
纯黑。 于是开始逐层排查:
| 实验 | 结果 | 排除/指向 |
|---|---|---|
| fp16 矩阵乘 / group_norm / silu 单元测试 | 全部有限 | 排除基础算子 |
| 文本编码器输出 | 有限 | 排除编码器 |
| 4 步短管线出 latents | NaN | 锁定去噪阶段 |
| 扫描 unet/vae 权重文件 | 686+248 个张量全完好 | 排除下载损坏 |
| 换 eager attention | 仍 NaN | 排除 attention kernel |
| 禁用 cuDNN 再跑 | 完全正常! | 锁定 cuDNN |
根因:cuDNN 9.24 在 Turing 老架构(SM 7.5)上的 fp16 卷积会产出 NaN。这是新版 torch 2.14 + cuDNN 9 组合在老卡上的兼容性问题。
但禁用 cuDNN 后原生卷积的工作区内存暴涨,单笔卷积要 2.25GB,直接 OOM。最终方案是三件套:
torch.backends.cudnn.enabled = False   # 1. 绕开 cuDNN bug
pipe.unet.to("cpu")                    # 2. 解码前卸载 UNet(1.7GB 大头)
pipe.vae.enable_tiling()               # 3. VAE 分块解码防 OOM
修复后:橘猫图正常出图,143 秒/张。作为基线,画质确实"能用但一般"。
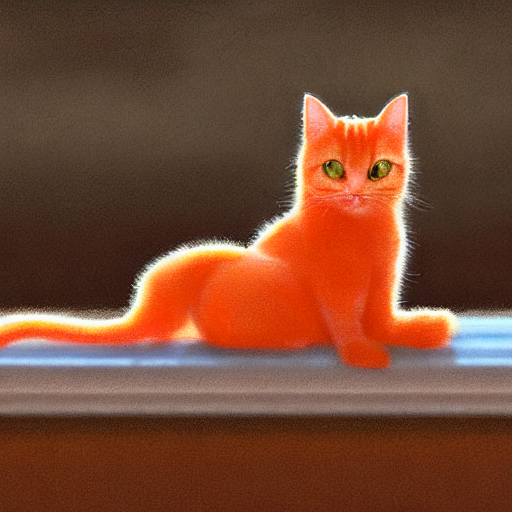
(修复 cuDNN 问题后,SD1.5 在这块 1650 上的第一张图)
五、Sana 1.6B:4GB 显存上的"极限运动"
SD1.5 只是及格线,真正想要 1024px 高画质,得上 NVIDIA 的 Sana 1.6B——线性注意力 DiT 架构,专为低算力设计。但它有个致命配置:Gemma2-2B 文本编码器(5GB fp16)+ 1.6B transformer(3.2GB)+ DC-AE VAE,加起来远超 4GB 显存。
CUDA OOM 的报错我见了一晚上。管线级量化、组件级 4bit、model offload……全部以 OOM 收场。最后的解法是一场"显存接力赛":
文本编码器(4bit)上GPU编码 → 立刻释放 → transformer独占GPU去噪 → 释放 → VAE在CPU解码
任一时刻显存里只有一个大件。期间还踩了一堆小坑:
| 坑 | 症状 | 解法 |
|---|---|---|
| bnb 4bit 不量化 embedding(1.2GB) | 装载即 OOM | device_map={"embed_tokens":"cpu","":0} 把它摁在 CPU |
| embed_tokens 键名猜错 | 整模型被推上 GPU | 真名是 embed_tokens,没有 model. 前缀 |
| encode_prompt 没包 no_grad | 每层反量化权重被驻留,显存翻倍 | 套上 torch.no_grad() |
| negative_prompt 与 embeds 冲突 | 500 报错 | 管线调用时显式传 negative_prompt=None |
| DC-AE fp16 数值溢出 | 解码输出异常 | 官方要求 fp32/bf16,VAE 保持 fp32 |
最终跑通:1024px 一张 430 秒,显存峰值 3.13GB。画质对比 SD1.5 是碾压级的——毛发纹理、光影层次都上了一个档次。
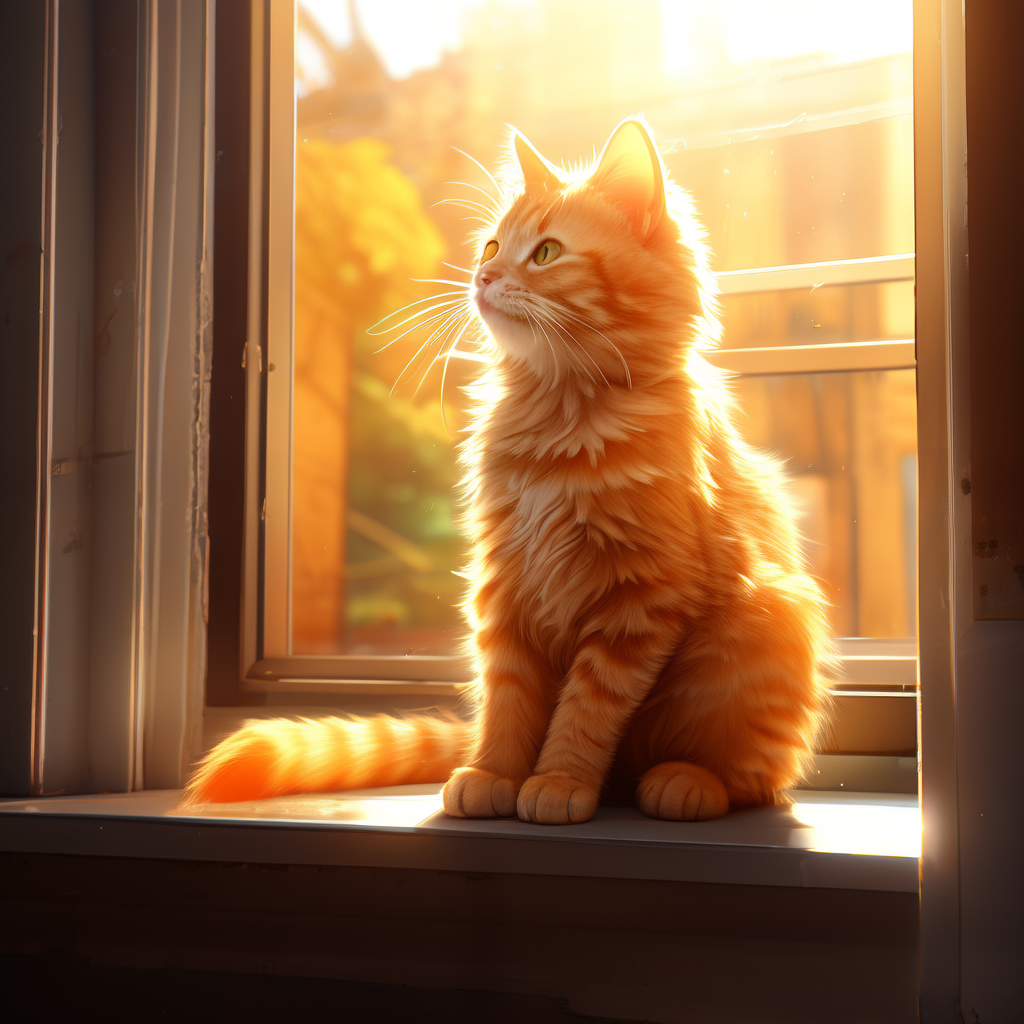
(Sana 1.6B 生成的橘猫,1024×1024)
六、SANA-Sprint:同一架构,快 7 倍的答案
Sana 画质虽好,但 430 秒一张的等待实在煎熬——我并不满意,一张图的时间够泡两杯茶。问题很自然:能不能既保住 1024px 的画质,又把速度提上去?查资料时发现了 NVIDIA 的 SANA-Sprint——同一架构的一致性蒸馏版,把 20 步推理压到 1-4 步,1 步的 FID 甚至超过 FLUX-schnell。更妙的是:组件完全相同,我趟出来的整套显存方案直接复用。
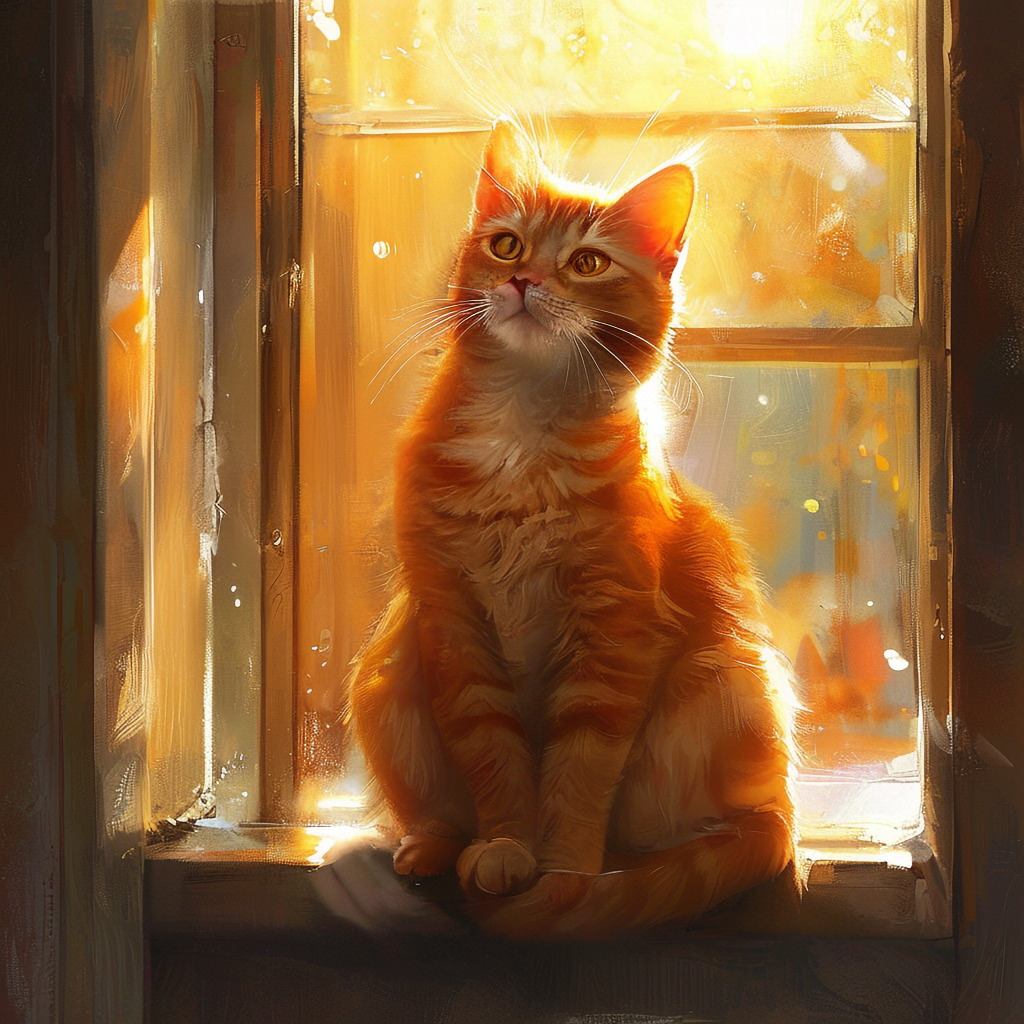
(SANA-Sprint 2 步生成的橘猫,1024×1024,油画质感)
当然,蒸馏模型也有新脾气。它用 SCMScheduler + trigflow 参数化,官方指定 bf16——而 GTX 1650 没有 bf16 硬件单元。我手贱转成 fp16"加速",结果 latents 直接 NaN 黑图;保持 bf16(PyTorch 软件模拟)不仅数值正确,反而比 fp16 更快(去噪 8.6s vs 29.5s)。
教训 2:老卡上"降精度加速"不一定成立,官方推荐的 dtype 有它的道理。
另外它的 encode_prompt 没有 CFG 参数(一致性蒸馏没有负向 prompt),管线调用接口也对不上普通版,这些差异都记在了代码注释里。
七、三模型同台:最终成绩单
同一个提示词(窗台上晒太阳的橘猫),三个模型在同一块 1650 上的真实表现:
| 指标 | SD1.5 | Sana 1.6B | SANA-Sprint |
|---|---|---|---|
| 分辨率 | 512px | 1024px | 1024px |
| 去噪步数 | 25 | 20 | 2 |
| 去噪耗时 | ~110s | ~390s | 8.6s |
| 端到端耗时 | ~143s | ~430s | ~60s |
| 显存峰值 | 2.48GB | 3.13GB | 3.11GB |
| 画质 | 玩具级 | 良好 | 最佳(油画质感、光影层次) |
三张图放在一起看,差距一目了然:SD1.5 的猫糊成一团色块,Sana 的猫已经像样,Sprint 的猫毛发根根分明、逆光的暖阳甚至有"作品感"。
画质和速度竟然是同向的——这是蒸馏技术送给低配机的礼物。
八、临门一脚:封装成 API 服务,systemd 常驻
能出图只是玩具,能被调用才是生产力。我把 Sprint 封装成 FastAPI 服务:
| 端点 | 功能 |
|---|---|
GET /health | 健康检查 |
POST /generate | 同步出图,返回 PNG base64(单并发,忙时 429) |
POST /generate_async | 提交任务进队列,返回 task_id |
GET /result/{task_id} | 查询异步结果 |
4GB 显存跑不了并发,服务内部同样采用"接力赛"调度:tokenizer 常驻,4bit 编码器每请求加载-释放,transformer 按需上卡,VAE 常驻 CPU 解码。全局锁保证同一时刻只有一张卡在干活。
然后写了一个 30 行的 systemd 单元:
[Service]
ExecStart=/opt/sd-env/bin/python -m uvicorn app:app --host 0.0.0.0 --port 8486
Restart=on-failure
RestartSec=15
Environment=PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True
systemctl enable --now sd-api,开机自启、崩溃自动拉起、日志进 journald。现在这台旧电脑是一台安安静静的文生图服务器:
curl -X POST http://<ip>:8486/generate \
  -H "Content-Type: application/json" \
  -d '{"prompt":"蜘蛛侠大战,比例9:16"}' \
  | jq -r .image_b64 | base64 -d > out.png
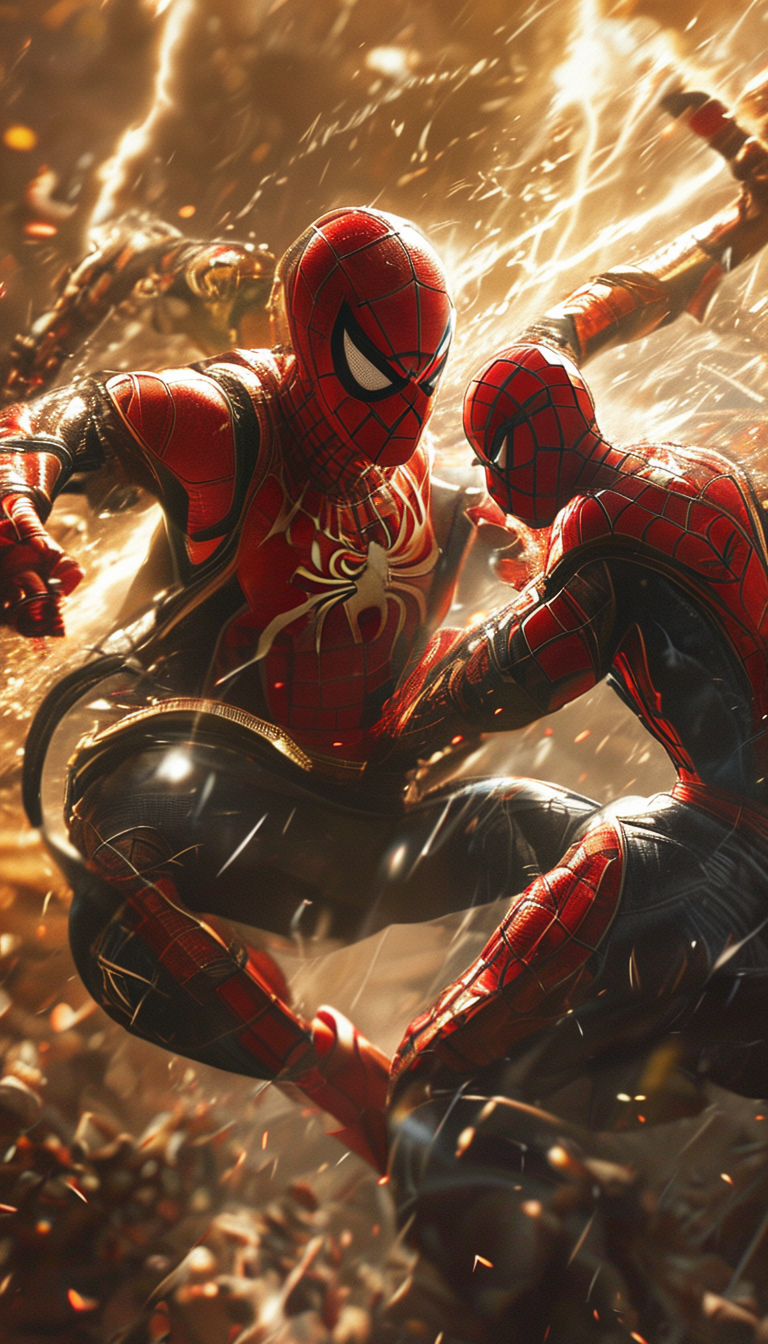
(通过 API 生成的第一张图)
九、复盘:低配机玩 AI 的四条心法
- 测速选源先行。国内环境,ModelScope 下模型、阿里云装 pip 包,动手前一分钟测速能省几小时。
- 官方推荐的 dtype 别乱改。老卡上 fp16 不一定比 bf16 快,NaN 黑图教我做人。
- 4GB 显存的答案是"时间换空间"。编码→释放→去噪→释放→CPU 解码,任一时刻显存里只放一个大件,6GB 需求的模型照样跑。
- 不要在报错堆里硬刚。黑图就二分定位(算子→编码器→去噪→解码逐层排查),OOM 就查显存水位,每个问题都有清晰的证据链。
这块 1650 或许永远跑不动大语言模型,但它现在是一台 60 秒一张 1024px 图的文生图服务器——旧硬件的宿命不是吃灰,而是找到适合它的那类任务。
环境备注:Ubuntu / Python 3.10 / torch 2.14.1+cu130 / diffusers 0.41.0 / bitsandbytes 0.50.2,模型与脚本均在文中注明路径。遇到同款黑图或 OOM 的朋友,欢迎交流。